

법률 리서치 도구를 붙인 생성형 AI가 제15회 변호사시험 선택형 150문항에서 만점을 받았다고 리걸테크 기업 쥬리서포트가 7월 31일 밝혔습니다. 같은 모델에서 도구만 떼어 낸 대조군은 한 번도 만점을 받지 못했습니다.
같은 시험의 선택형 만점은 이번이 처음이 아닙니다. 로앤컴퍼니의 '슈퍼로이어'도 6월에 만점을 발표했습니다. 두 회사가 내세운 것은 모델이 아니라, 법령과 판례를 찾아 확인하는 절차와 데이터였습니다.
도구를 붙이자 아홉 번 모두 만점
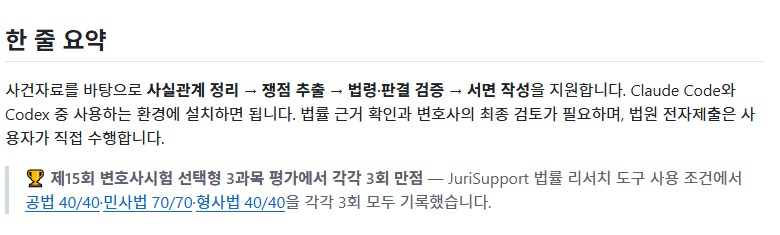
과목마다 모델이 달랐습니다. 공법 40문항은 GPT-5.6 Sol, 민사법 70문항과 형사법 40문항은 클로드 오푸스 5였고, 각 모델에 법령·판례·교재를 검색하는 리서치 도구를 연결했습니다. 과목별 세 차례씩 아홉 번 시험을 봤고, 법무부가 공개한 정답 기준으로 아홉 번 모두 만점이었습니다.
대조군은 같은 모델에서 리서치 기능만 뺐습니다. 공법 평균 33점(40점 만점), 민사법 세 차례 모두 65점(70점 만점), 형사법 37·35·36점(40점 만점)으로 만점은 없었습니다. 하희봉 대표는 도구 없이 반복해서 틀린 문항이 도구를 붙이자 전부 교정됐다고 설명했습니다.
검색 재료는 공개 자료, 도구는 오픈소스
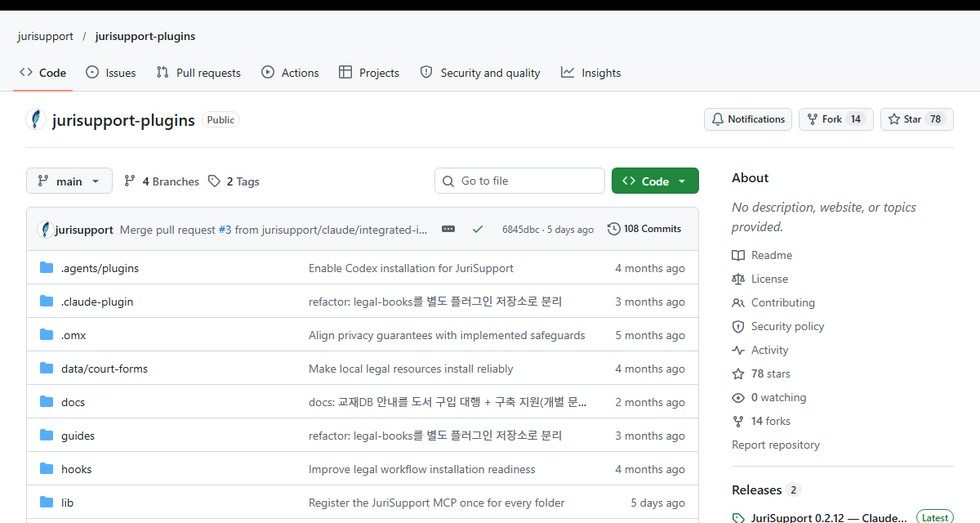
검색 대상은 공개된 법령·판례 데이터와 회사가 가진 법률 교재였고, 별도의 비공개 자료는 쓰지 않았다고 회사는 밝혔습니다. 실험에 쓴 도구는 MIT 라이선스로 공개했습니다.
깃허브 저장소에서는 이 플러그인이 사건자료를 바탕으로 사실관계 정리, 쟁점 추출, 법령·판결 검증, 서면 작성을 돕고, 클로드 코드나 코덱스에 설치해 쓴다고 설명합니다. 같은 실험을 누구나 다시 해 볼 수 있게 열어 둔 셈입니다.
만점은 하나가 아니었다, 다만 재료가 다르다
로앤컴퍼니는 6월 24일 '슈퍼로이어'가 같은 15회 시험 선택형 150문항을 모두 맞혀 375점 만점을 받았고, 같은 시험 수석의 360점보다 15점 높다고 밝혔습니다. 지난해 3월 14회 시험에서 111문항으로 합격선(96문항)을 처음 넘은 뒤 1년여 만의 결과입니다.
방식은 대조적입니다. 슈퍼로이어는 판례 530만 건과 박영사 법률서적 10년 독점 계약 같은 자체 데이터베이스, 여러 상용 대형언어모델 조합을 내세웠습니다. 쥬리서포트는 공개 데이터와 오픈소스 도구로 같은 결과를 보였습니다. 둘 다 모델 하나의 실력보다 무엇을 찾아 확인하게 했느냐를 강조했습니다.
만점이 말하지 않는 것도 분명합니다. 쥬리서포트는 이번 결과가 5지선다 선택형에 한정되고, 사례형·기록형 답안 작성 능력이나 실제 시험의 시간 제한 조건과는 다르다고 먼저 밝혔습니다. 변호사 업무에 AI를 쓴다면, 검증 가능한 리서치 절차가 성적보다 먼저 볼 지점입니다.